本文由英文原文借助 AI 翻译整理,点此查看英文原文。
这篇论文是导师推荐给我的。他让我读懂这篇文章,并掌握它所使用的方法。毕竟,这篇文章发表在《自然》(Nature)上——一份我大概一辈子只能远远仰望的期刊。
论文引用:Ren, C., Zhou, X., Wang, C. et al. Ageing threatens sustainability of smallholder farming in China. Nature 616, 96–103 (2023). https://doi.org/10.1038/s41586-023-05738-w

概述
研究问题:老龄化如何影响农业可持续发展?应采取哪些措施来缓解老龄化的影响?
研究思路:
- 使用多元回归模型(MRM)检验农村人口老龄化(家庭层面 65 岁以上人口占比)与农业可持续性之间的关系。
- 引入结构方程模型(SEM),展示直接影响路径与间接影响路径。
- 比较传统小农户与新型农业模式(合作社、大规模农场)之间的表现差异。
- 预测不同政策干预(例如推广新型模式)下农业可持续性指标的变化(至 2100 年)。
老龄化是坏事
描述性分析:
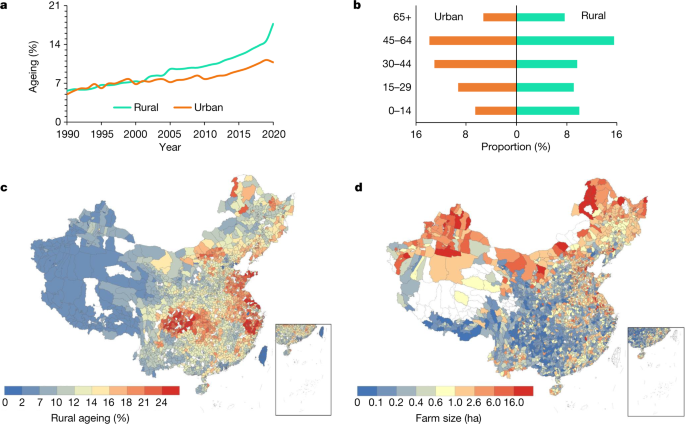
作者用两张地图展示了县级层面的老龄化程度与农场规模,直观地呈现出:老龄化严重的地区,农场往往更小。(顺便说一句,我认为在特定条件下,用地图展示研究结果是个好办法,但很多人担心它可能带来潜在的政治风险。)
多元回归(MRM)分析:
Y(农业可持续性):农业总投入、总产出、劳动生产率、化肥投入、有机肥、化肥流失、农民收入、农场规模与机械投入。
X:老龄化(农村家庭中 65 岁及以上人口占比)、教育(家庭成员 15 岁及以上的平均受教育年限)、农场规模(涵盖所有作物的总耕地面积取对数)。
控制变量:成年农民比例(Adult)、收入比(来自非农部门的收入占比)、作物类型、地块数量、县级与年份固定效应。
结果:老龄化与农业投入下降相关——在其他条件不变的情况下,老龄化比例每上升 1 个百分点,总投入下降 0.3%,主要涉及化肥、有机肥以及机械与技术的采用。相应地,在其他条件不变的情况下,老龄化比例每上升 1 个百分点,农业产出与单位面积产量分别下降 0.33% 和 0.14%,进而导致劳动生产率下降。(表 1 与补充表 1)
Tobit 回归模型:
耕地转出与转入、耕地撂荒、机械与有机肥投入这些变量中,有一部分取值为 0,但在正值区间上是连续分布的。
针对这些取值,作者采用 Tobit 模型进行验证,得到了与 MRM 相近的结果。
反事实分析:
假设老龄化水平仍高于 1990 年的水平,作者用一种非常简洁的方法估算了这一情形下 2019 年本应达到的农业发展水平。
首先,作者计算了 2019 年与 1990 年之间,由老龄化变化(AG)所导致的农业可持续性被解释变量的差异。在这个模型(式 2)中,自变量是 2019 年与 1990 年之间老龄化程度的差异与成年人口比例的差异,因变量是这两年之间农业可持续性指标的差异。
$$ begin{multline} text{Agriculture}_{it} = alpha + beta times text{Ageing}_{it} + gamma times text{Education}_{it} \ + delta times text{Farm_size}_{it} + theta_{1} times text{Adult}_{it} + theta_{2} times text{Income_ratio}_{it} \ + theta_{3} times text{Crop_type}_{it} + theta_{4} times text{Plot_number}_{it} + varphi_{t} + mu_{it} tag{1} end{multline} $$
$$ Delta ln Y_{ij}^{AG} = beta_j times Delta text{Ageing}_{ij} + theta_{1j} times Delta text{Adult}_{ij}tag{2} $$
我盯着这个方程看了一会儿,想不通它为什么有解,后来才意识到:这里的 β 和 θ 用的是前面用 2019 年全部数据估计的完整公式(式 1)的系数结果。也就是说,假设其他一切不变,只改变这两个 x 的大小,会对 y 产生何种影响。
所谓反事实分析,就是把 2019 年的老龄化和成年人口替换成 1990 年的数字后,y 会变成什么样。这个思路很好。
为什么老龄化是坏事
根据前面 MRM 回归中系数的符号,作者提出了几条影响路径:
- 老龄化 → 教育水平下降 → 方法不够科学、不够前沿
- 老龄化 → 农场规模变小 → 更多耕地被撂荒或转出
- 老龄化 → 农业投入减少 → 劳动生产率下降
SEM 分析:
我的一位朋友说,她没想到 SEM 会出现在这样的期刊上,在她的印象里这是一种层次很低的方法。我对 SEM 了解不多,但我读到的文章里,它通常用来分析问卷题项的结果。在我这个层级的研究者中,问卷研究本身就很难做到科学合理,所以我完全理解她的看法。但这并不意味着这种方法有什么问题。

我们能做些什么来避免这种糟糕局面
2010 年代以来,中国政府鼓励并推动新型农业经营模式不断涌现,主要包括家庭农场、合作社和产业化经营,以改变以小农户为主的现状、提升农业整体绩效。
作者认为,新型农业模式能够有效缓解老龄化的影响。首先,双样本 T 检验显示,新型农业模式在相关指标(老龄化、农场规模等)上显著优于传统农业。
基于 SSP 的情景预测
共享社会经济路径(Shared Socioeconomic Pathways, SSPs)是气候研究界开发的一组情景,用于探讨全球社会、人口与经济在 21 世纪可能如何演变。它们与描述不同温室气体排放水平的代表性浓度路径(Representative Concentration Pathways, RCPs)配合使用,以分析社会经济发展与气候变化之间的相互作用。
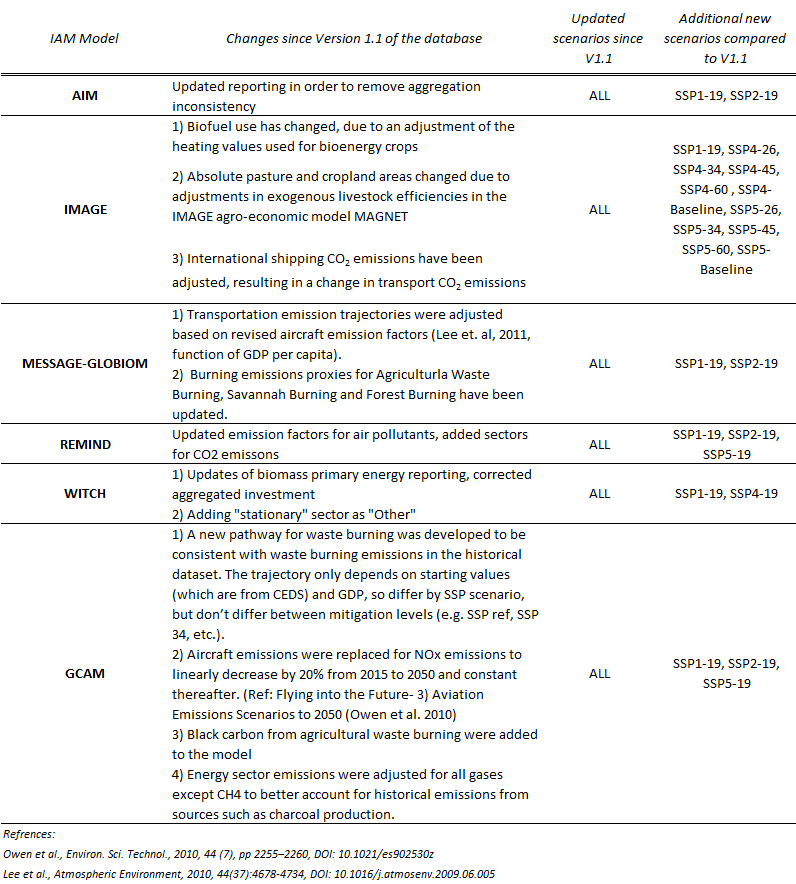
作者以 SSP 情景为基础分析未来的社会经济发展,以确定人口老龄化对农业可持续性的影响。研究推导了 2020—2100 年家庭层面的老龄化、成年农民比例与教育数据。在假设其他变量保持 2019 年水平的前提下,计算了未来老龄化与教育背景下农业可持续性指标的预测值。
结果显示,在不同的 SSP 情景下,引入新型农业经营形式所预测的未来农业可持续性指标,都显著优于不引入新型农业经营形式的情形。这表明,与老龄化相关的农业绩效下滑,可以通过推动新型农业经营模式的普及来扭转。
评论
我认为这篇文章最出色之处在于,它不仅验证了当下老龄化与农业可持续性受威胁之间的相关性,还深入分析了如果老龄化停留在过去水平、情况会有何不同。通过 SSP 预测,它进一步探讨了面向未来的反事实情景,从而验证了其提出的核心解决方案——新型农业模式的前景。这种研究路径,比仅仅提出缺乏依据的对策要具体得多、可靠得多。
在方法上,这篇文章密集的定量手段承载了丰富的信息。需要重点学习的方法包括 MRM、SEM 和 Tobit。作者的反事实分析思路很有启发性,让我理解了 SSP 数据库与预设情景的价值。
说实话,对于像我这样计量背景有限的人来说,要完全读懂这类论文可能需要一个月。确实有很多地方我还没想明白。尽管这篇文章提供了大量材料,但具体的实现细节和解释分散在不同的材料里,需要仔细阅读才能把线索串起来。
附:研究方法补充
多元回归模型(MRM):
一种用于考察单一因变量(结果)与两个及以上自变量(预测变量)之间关系的统计技术。它在简单线性回归的基础上引入多个预测变量,从而能够在控制其他变量的同时,分析每个变量对结果变异的解释贡献。模型形式为:
$$ Y=β_0+β_1X_1+β_2X_2+⋯+β_kX_k+ϵ $$
Y:因变量。β0:截距(所有预测变量为 0 时的基线值)。β1, β2, …, βk:表示各自变量 X1, X2, …, Xk 对 Y 影响的系数。ϵ:误差项(无法解释的变异)。
关键假设包括线性、误差独立、同方差(误差方差恒定)、误差正态,以及自变量之间不存在严重的多重共线性。
应用:预测结果、检验假设,或控制混杂因素。例如,根据面积、地段和房龄预测房价,并同时调整其他变量。
结构方程模型(SEM):
一种用于研究变量之间复杂关系的统计方法,用来理解多个变量在现实系统中如何相互作用。它结合了:
- 因子分析:用多个观测变量(如问卷题目)测量潜在概念(如”客户忠诚度”)。
- 路径分析:检验直接效应与间接效应(如”教育 → 收入 → 生活满意度”)。
步骤:
- 定义模型:画出变量之间的关系图(如”压力 → 睡眠质量 → 工作绩效”)。图中同时包含观测数据(如问卷得分)与潜在因素(如”压力”)。
- 收集数据并运行分析:使用软件(如 AMOS、R 的 lavaan)检验数据是否拟合你的模型。
- 验证与解释:检查拟合指标(如 RMSEA < 0.08 表示拟合良好),解释路径系数(如”压力使睡眠质量下降 30%”)。
Tobit 回归模型:
当被观测的因变量(Y)取值范围受限(例如 Y 只能取非负值,或在某一固定值上下被”截断”),而潜在的真实变量(Y*)可能超出这一范围时,传统线性回归(OLS)会产生偏误。Tobit 模型可以纠正这一偏误,给出更准确的参数估计。
Tobit 可以解决:
- 数据删失(Data Censoring):因变量 Y 的观测值在某一阈值处被删失(例如农业研究中,农民的”化肥使用量”最小为 0/不施肥,但潜在需求可能为负)。
- 数据截断(Data Truncation):数据收集时直接排除了某一范围之外的样本,导致真实数据缺失。例如研究”农场规模对生产效率的影响”时,只调查 1 公顷及以上的农场,而忽略了小规模农户。
- 样本选择偏误(Sample Selection Bias):因变量受到某种选择机制的约束(例如只有参与特定农业项目的农户才能获得高额补贴,未参与者数据缺失)。
步骤:
$$ begin{equation} Y_i = begin{cases} Y_i^* = beta X_i + epsilon_i & text{if } Y_i^* > c \ c & text{if } Y_i^* leq c end{cases} quad text{where} quad epsilon_i sim N(0, sigma^2) end{equation} $$
- 确认是否需要 Tobit 模型:观察 Y 是否在某一阈值(c)处大量堆积(例如 50% 的农户化肥使用量为 0);检查 OLS 结果,若残差在截断点附近出现系统性偏离,就应当使用 Tobit。
- 模型设定:$Y_i^∗$ 为潜变量,服从正态分布:$ϵ_i∼N(0,σ^2)$。
- 参数估计:极大似然估计(MLE):通过对潜变量的线性部分与误差项方差进行联合估计来实现。
- 结果解读:β 表示 X 对潜变量 Yi* 的边际效应(与 OLS 不同)。但是,实际观测到的使用量下降,需要用边际效应公式另行计算。
局限与替代方案:
- 强分布假设:要求误差项严格服从正态分布才能得到一致估计。对于非正态误差:可使用 CLAD(Censored Least Absolute Deviations)等半参数方法。
- 同方差假设:若存在异方差(例如大农场与小农场的误差方差不同),应使用异方差 Tobit 模型。
- 角点解问题:当 Y 的观测值聚集在特定取值上,而理论上可能超出该值时,可考虑两部分模型(Two-Part Model,如 Logit + OLS)。
- 样本选择偏误:可考虑使用 Heckman 选择模型。
- 删失点需明确:当删失机制不清晰时(例如复杂的缺失数据模式),该方法可能不适用。
ln(x+1) 变换的 MRM 与 Tobit 模型的比较
对数变换(ln(x+1) + MRM)
- 因变量右偏,但取值为 0 的比例较低(如 <20%),或 0 代表”真实的零”(如没有收入)。
- 解释因变量相对于解释变量的百分比变化(弹性)。
- 数据不存在严重截断,变换后残差近似正态分布。
Tobit 模型:
- 因变量有大量取值为 0(如 ≥30%),且 0 代表角点解,是一种主动选择。
- 展示解释变量对因变量的绝对效应(如 X 每增加 1 个单位,Y 增加 β 个单位)。
- 数据存在潜在的连续分布(未被观测到的 Y*)。
阅读于 2025/3/23